在计算机系统的监控中,采集指标通常有两种方式:
- Push
- Pull Push 是数据产生端由事件驱动,主动向采集端发送指标数据,与之相对应的 Pull 是由采集端定时拉取数据。
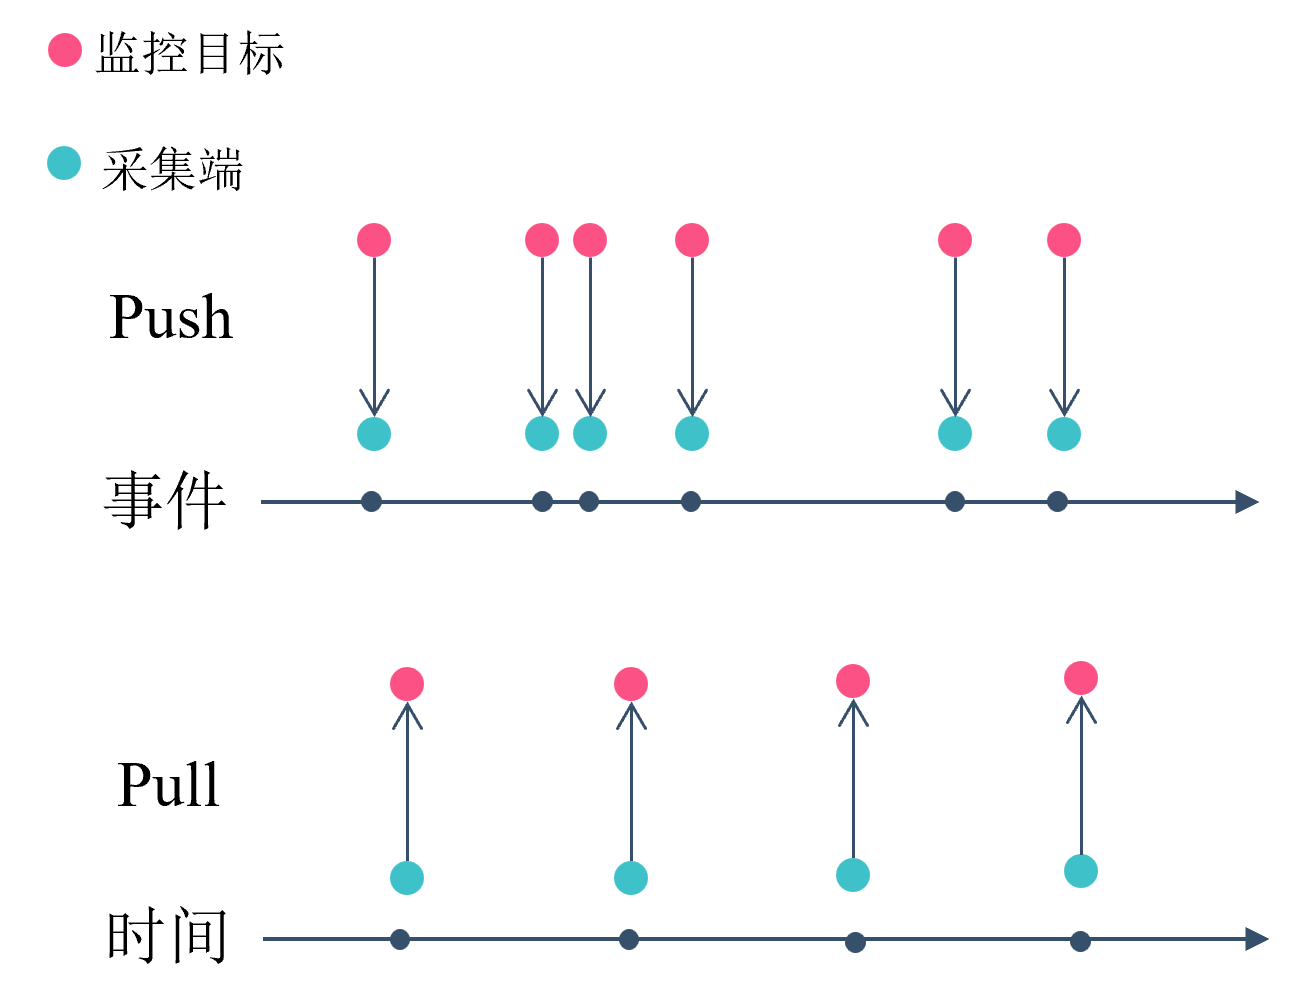
作为目前云原生监控中扛把子的 Prometus 采集数据采用了 Pull 模式,虽然在官方文档 FAQ 中给出了理由:
- 可以在笔记本上监控开发时产生的变更
- 如果监控目标宕机了可以更容易被发现
- 可以通过 web 浏览器手工访问监控目标并检查其健康状况
但是这些不能说明 Pull 模式的优点,在前段时间在推特上看到了一个关于 Prometheus 采用 Pull 模式的Twitter讨论,为此本文
Prometheus 的设计理念
Prometheus 的 slogan 是「metrics to insight」,意思是它仅仅关心标准化地采集给定指标的当前状态,而不是导致这些指标的底层事件,所以其不是基于事件的监控系统。
例如,计量服务不会发送关于每个 HTTP 请求的消息给 Prometheus 服务器,而是在内存中简单地累加这些请求。每秒可能会发生成百上千次这种累加而不会产生任何监控流量。Prometheus 然后每隔 15 或 30 秒简单地问一下这个服务实例当前状态的累积值而已。监控结果的传输量很小,拉取模式也不会产生问题。
如果是基于事件的监控系统,需要在每一个事件「HTTP 请求、异常」发生时立即向监控服务器报告,监控服务器可以汇聚事件为指标或保存事件用于后续处理,例如ELK。
监控目标的配置更少
采用 Pull 模式,不用知道监控目标中的具体信息,也不用在监控目标不用维护指标推送的服务,这些工作都由数据采集端统一管理,而采用 Push 模式那么就需要更多的资源。
因此,采用 Pull 模式的业务开发中,只需要保证自己服务的数据能够被采集到,采集出错或异常由采集端统一处理。这样对于监控目标的应用开发来说会更简单。
Push 模式会要求更多的配置,采集端要知道监控目标,监控目标还要知道数据采集服务器,同时还需要在应用端编写错误处理、连接建立等代码,这大大增加了监控目标的负担。
掌握主动权
无论哪种模式,如果发送给时序数据库的数据量超过它的处理能力都会导致服务器宕机。但是存在的区别是, Push 模式通常会由业务开发人员在业务逻辑中编写,由于其水平参差不齐,代码编写存在着问题将会造成对监控服务造成巨大的负载;而监控团队通常就一个 Team,通常是对监控系统的熟悉程度更高,代码质量相对可控,因此 Pull 模式能够将这一部分风险降低。
更好控制数据粒度
pull 模式能够有更好的控制数据的粒度,不管是画图,还是做算法分析,数据预处理的过程都会比较简单
Pull 模式的缺点
当然采用 Pull 也会带来一些问题:
- 如果监控对于实时要求很高的服务,这种系统拉取确实会导致问题,计量服务必须在拉取的间隔中间缓存事件,拉取的频率也要非常高才能接近推送模式的效果。
- 当应用服务或监控目标的网络不可达,例如如 IoT 环境,Pull 模式几乎不可能。这个时候就需要采取 pushgateway 的方式
如果必需要使用 Push 模式,Prometheus 提供了 Pushgateway的方式,但实际上 pushgateway 和 prometheus 之间依然是 pull 模式。
总结
Prometheus 官方并没有对选择 Pull 的方式的原理进行详细说明,但是显然,Prometheus的设计理念就决定了其必定采用 Pull 的模式,这奠定了相比于Zabbix、 Nagios更加的易用。
Reference
- https://prometheus.io/docs/introduction/faq/#why-do-you-pull-rather-than-push
- https://prometheus.io/blog/2016/07/23/pull-does-not-scale-or-does-it/
- https://prometheus.io/docs/instrumenting/pushing/
- https://twitter.com/_a_wing/status/1512451830814437385
转载申请
本作品采用知识共享署名 4.0 国际许可协议进行许可,转载时请注明原文链接,图片在使用时请保留全部内容,可适当缩放并在引用处附上图片所在的文章链接。